LOCAL AI / 本地部署手记
双卡跑文本,单卡看图,再留一张做实验。这次,我想解决的是本地 AI 能不能连续几个小时,踏踏实实地干活。
封面:本地AI资源分工概念图,AI生成
以前看着手里的四张 RTX 3090,我总觉得:既然有四张卡,就应该把它们绑在一起,跑一个更大的模型。
折腾到现在,我的想法变了。
两张卡负责文本,一张卡专门看图,剩下一张留给实验。 让每张卡都有合适的工作,比让所有卡都挤进同一个推理实例,更符合我现在的需求。
顺便介绍一下这套机器的另一位“使用者”。
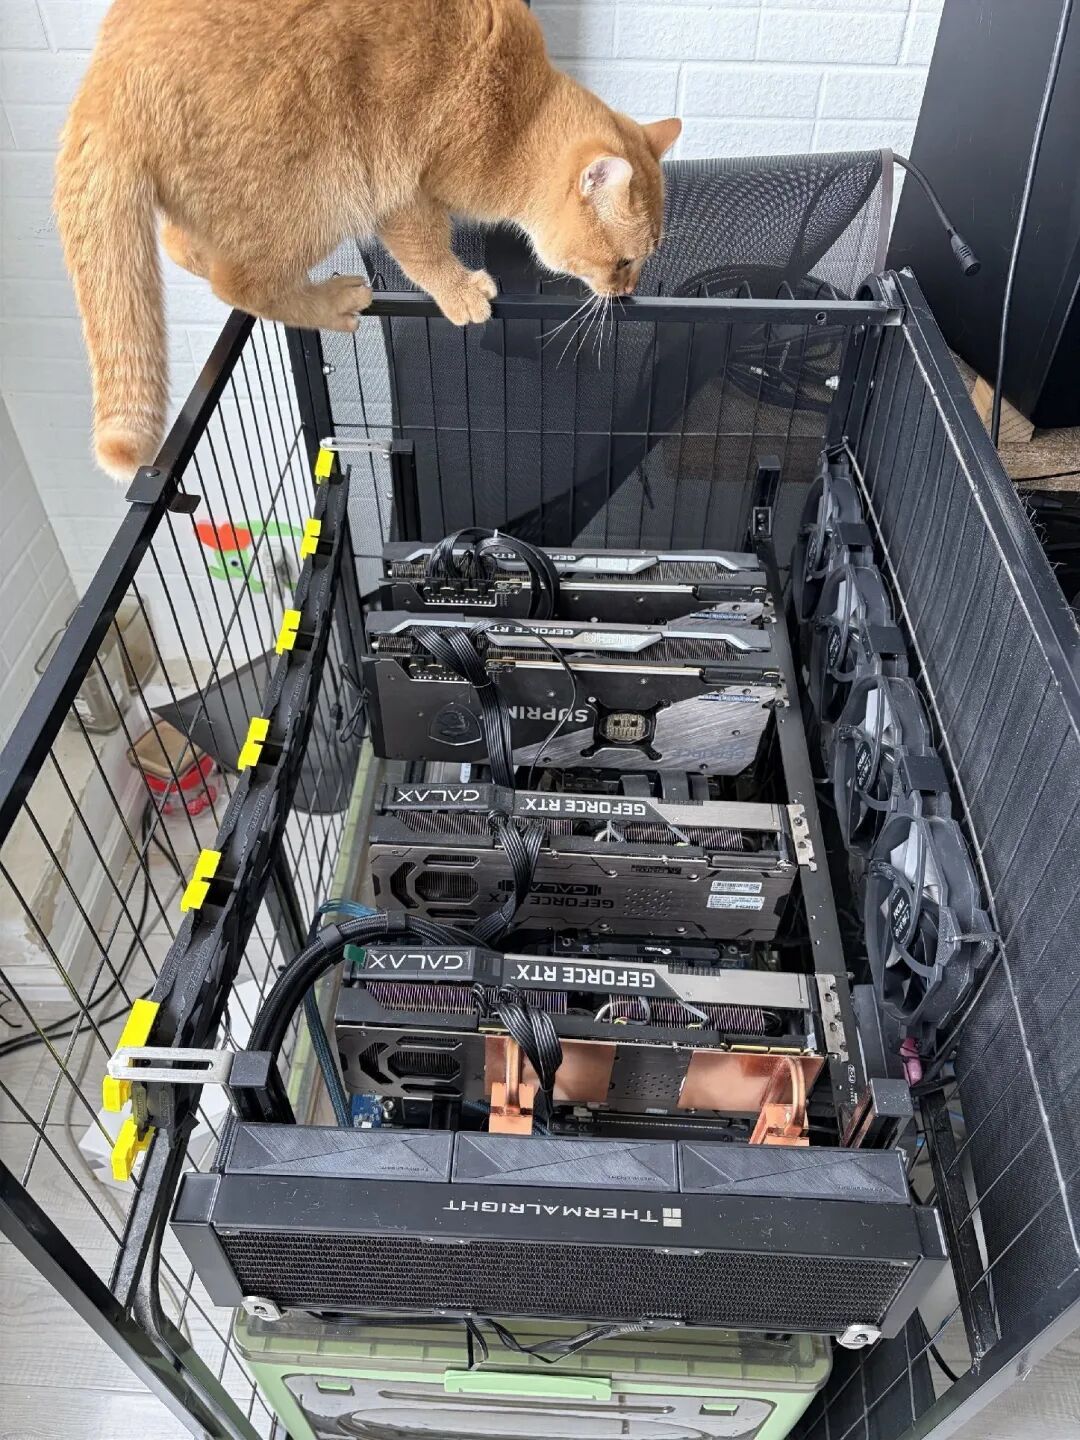
我的四卡工作站,以及前来巡视的啾啾。
这个“猫笼机箱”,就是为了防它。至于里面的显卡,我也终于重新安排好了分工。
01|跑到100 tok/s以后,我开始在意别的事
上一阶段,我已经通过 Strata Custom Fork,让 Qwen3.8 Flash Next 在单张 RTX 3090 上跑到了 100+ tok/s。
速度有了,接下来我更关心的是:如果让它长期承担 Agent、代码、文件分析,连续工作几个小时,我还愿不愿意继续用当时的低量化配置?
于是,这一轮我把目标改成了:在自己愿意长期使用的量化质量下,把速度、上下文容量和稳定性一起保住。
现在,文本部分使用 Qwen3.8 Flash Next IQ4_XS,运行在两张 RTX 3090 上,Runtime 是 Niko1221/Strata v0.1.39。
多用一张卡,对我来说是一次取舍:从 IQ3 切换到 IQ4_XS,同时保留 200K 的上下文配置,以及每秒百余 token 的实际生成速度。
02|最让我满意的,是150K长会话还跑得动
先把这次使用中的几个数字放在一起。
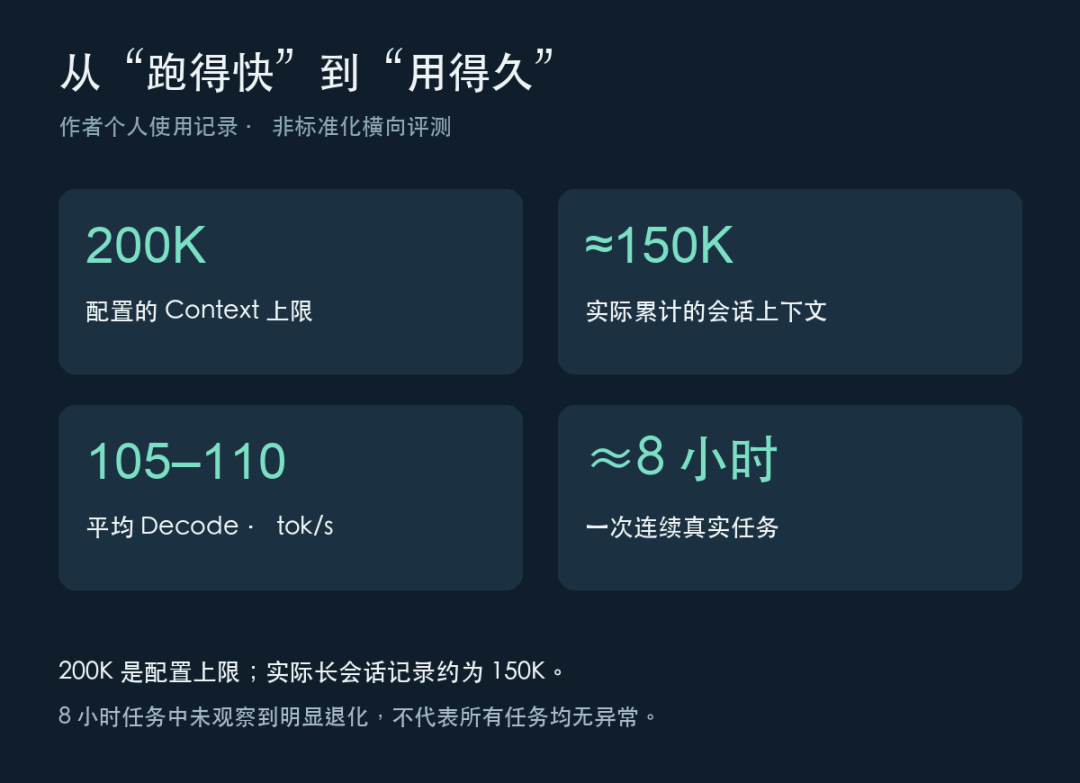
当前配置与个人实测:200K上限、约150K实际会话、105—110 tok/s、约8小时连续任务。
这里有个需要说清楚的区别:200K 是我设置的 Context 上限,约 150K 是实际会话已经累计到的长度。
这个 150K,不是为了测试临时塞进去的一段超长 Prompt,而是一个在真实工作中不断增长的 Session。
在这个会话里,平均 Decode 仍约为 105~110 tok/s。Decode 指生成阶段的速度,不等于整个 Agent 工作流的端到端处理速度。
我在意的正是这种使用状态:已经聊了很久,已经做过大量工具调用,上下文已经积累到十几万 token,它还能不能继续顺畅地干活?
目前,这套配置给我的体验比预期好。
另外,我完成过一次约 8 小时的连续实际任务。不是让模型不停地吐字,而是运行我平时真正使用的长任务工作流。
在这次任务中,我没有观察到明显的幻觉恶化、重复循环,或随着上下文增长而出现的输出失控。
当然,这不能说明 IQ4_XS 不会幻觉,也不能把一次任务的观察推广到所有场景。它说明的是:在我这次长时间、长上下文的实际使用中,系统没有出现明显退化。
对我而言,这比一张更高峰值的跑分截图更有参考价值。
03|看图这件事,我交给了另一张卡
我的日常工作不只有文本。Hermes Local 和 DSH Local 还会遇到截图、图片、界面,以及文档里的视觉内容。
如果要求文本主模型同时承担这些工作,模型选择、Runtime、显存和上下文管理都会增加约束。
所以我把视觉能力单独拆了出来,做成一个 Vision Sidecar。可以把它理解为:一个按需调用、专门负责看图的独立助手。
它的配置很直接:
模型: Qwen3-VL-4B-Instruct
精度: BF16
Runtime: vLLM
硬件: 独占一张 RTX 3090
普通文本、代码、Agent 和长上下文任务,交给 Flash Next;遇到图片,就调用 Vision Sidecar。视觉结果返回后,再由文本主模型继续推理。
我没有要求这个 4B 视觉模型承担复杂的主推理。它在这套系统里的职责,是看清图片、提取信息,并把有用的视觉结果交回来。
有独立的一张 24GB 显卡,我可以直接使用 BF16。文本和视觉也都能选用适合自己的 Runtime,不必为了共用显存反复妥协。
04|四张卡,从一个大实例变成资源池
现在的分工可以用一张图说明。
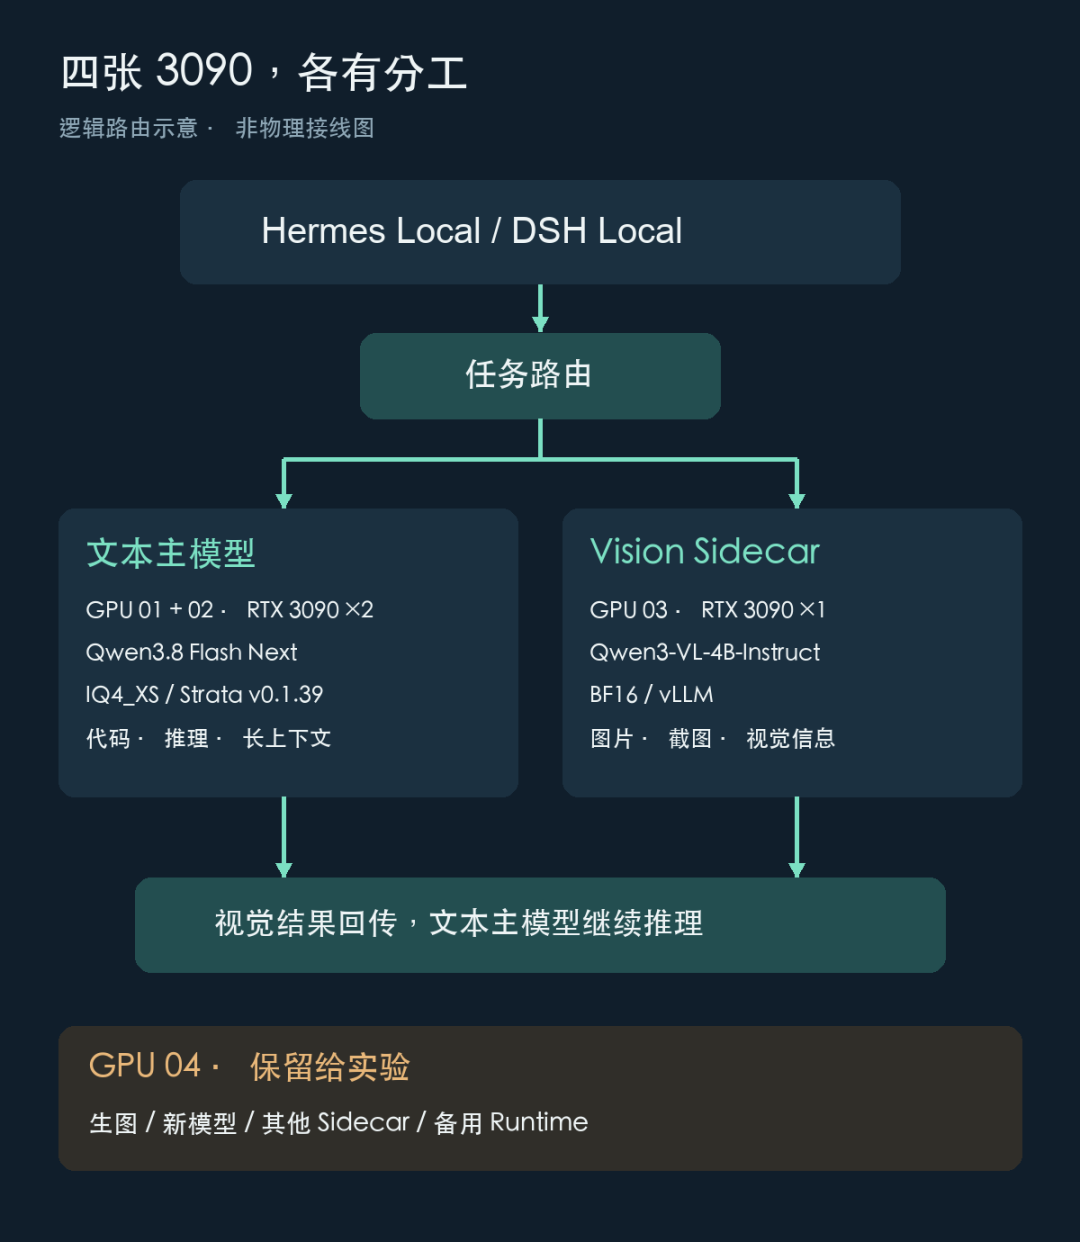
本地Agent逻辑架构:双卡文本、单卡视觉、第四张卡用于实验。
这套常用工作流实际占用三张卡:两张负责文本,一张负责视觉。第四张卡保留下来,可以做生图、新模型测试、其他 Sidecar,或者运行备用 Runtime。
过去,我会想“四张卡怎样一起跑一个模型”;现在,我更常想“这个任务应该交给哪张卡、哪个模型”。
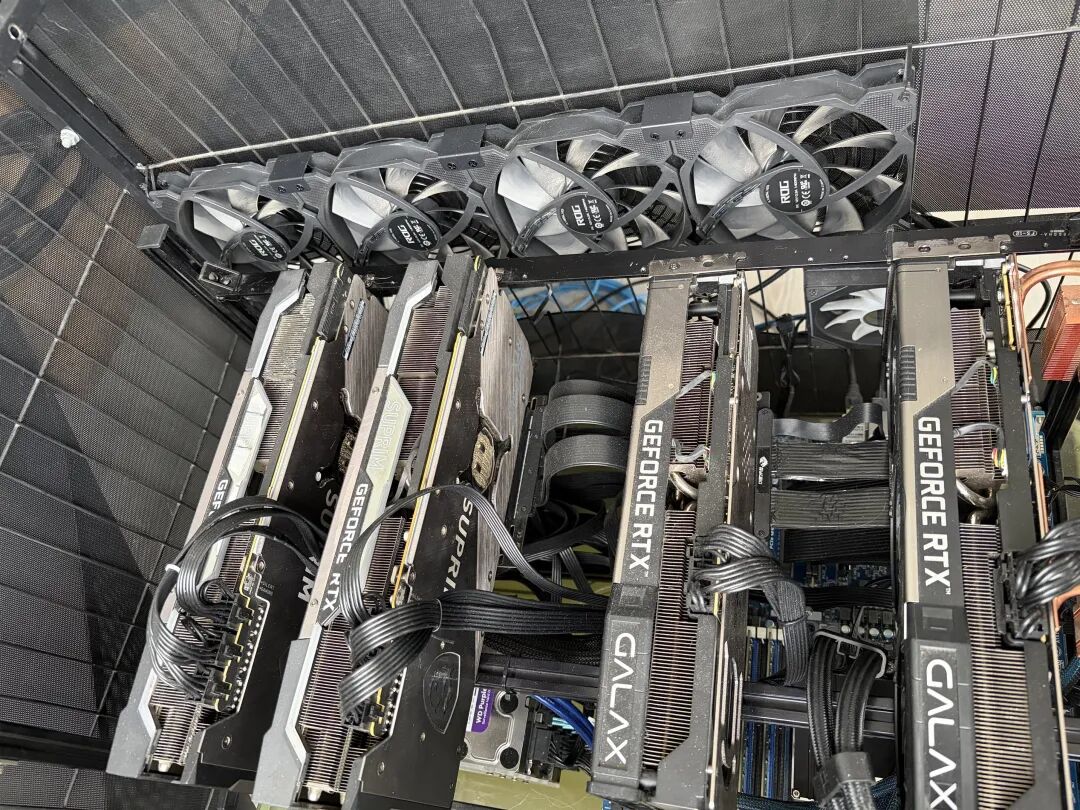
四张RTX 3090的硬件实拍。图中物理位置不对应上面的逻辑编号。
对上层 Agent 来说,底层具体由哪张 GPU 工作,并不需要反复操心。文本走文本模型,图片走视觉模型,最后回到同一个工作流。
这种分工,让这台机器更接近我想要的日常工具:聊天、代码、文件分析、长文处理、截图理解,都可以按任务需要在本机完成。
05|我说的“Token自由”,到底是什么
这里的“Token 自由”,指的是:常规任务不再受外部 API 的 token 计费和额度约束。
以前跑几个小时的 Agent 任务,我会自然地去想:已经用了多少 token?账单会涨到多少?要不要为了成本压缩历史记录?
现在,任务需要跑 1 小时、3 小时,甚至 8 小时,或者需要继续保留十几万 token 的上下文,我更关心的是本机资源和任务本身。
成本依然存在:显卡、电费、运行时间,还有部署维护的精力。只是对这些常规任务而言,成本不再随着每一次 API 调用持续累加。
这就是我目前获得的“Token 自由”。它有明确的适用范围,却已经足够改变我的日常使用方式。
写在最后|我更想要一套能长期干活的系统
上一阶段,我在验证:消费级 RTX 3090,能不能把这个模型跑得足够快?
这一阶段,我在验证:跑得快之后,它能不能成为我长期使用的主模型?
目前,我的答案开始变成“可以”。
我也越来越倾向于一种本地 Agent 形态:由一个强文本主模型负责推理和长上下文,再按需调用视觉、Embedding、OCR、语音或生图等专门能力。
这些能力不必一次装齐,也可以分别升级。
四张 3090 的价值,正在从“能装下多大的模型”,变成“能支撑多少真正有用的工作”。
这是这一轮折腾,最让我满意的变化。
——